Un fallo de sistema no siempre aparece de golpe. Antes de una parada completa pueden surgir lentitud, errores repetidos, reinicios, pérdida de conexión, falta de espacio, servicios que dejan de responder o usuarios que empiezan a detectar comportamientos anómalos. Atender esas señales a tiempo puede evitar que una incidencia menor termine afectando a todo un departamento.
En una empresa, además, el origen raramente está aislado. Un fallo que parece de software puede estar provocado por almacenamiento, red, permisos o un servidor saturado. Por eso el diagnóstico debe partir del síntoma, pero continuar hasta identificar la causa y comprobar si existen dependencias afectadas.
Causas habituales de los fallos de sistema
Hardware degradado o sin capacidad suficiente
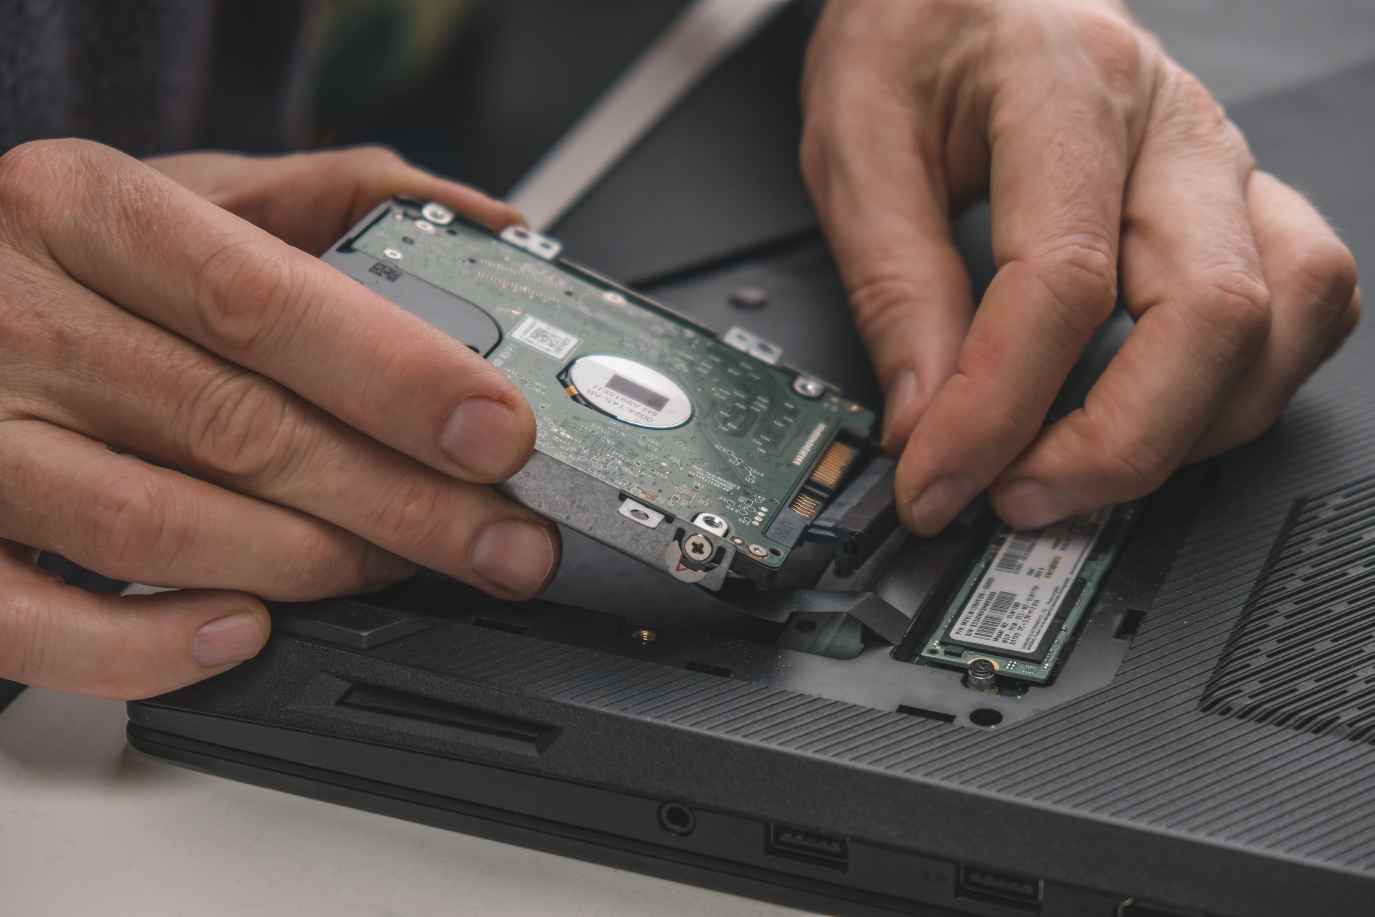
Discos con errores, memoria inestable, fuentes de alimentación defectuosas o equipos trabajando de forma constante al límite pueden generar bloqueos y pérdidas de rendimiento. También la falta de espacio disponible puede impedir actualizaciones, copias, creación de archivos temporales o crecimiento de bases de datos.
La solución no consiste siempre en sustituir hardware. Primero hay que confirmar el componente responsable y revisar si el problema procede de una mala configuración, de una carga puntual o de una capacidad que ya no encaja con el uso actual.
Software, actualizaciones y cambios de configuración
Una nueva versión puede corregir errores y vulnerabilidades, pero también introducir incompatibilidades si se despliega sin comprobar requisitos. Del mismo modo, mantener versiones obsoletas puede dejar fallos conocidos sin resolver. La gestión de cambios debe documentar qué se modifica, cuándo y con qué plan de reversión.
Los fallos también pueden aparecer por servicios detenidos, controladores, conflictos entre aplicaciones o permisos modificados. Registrar los cambios recientes es una de las preguntas más útiles durante el diagnóstico: qué cambió justo antes de que empezara el problema.
Red, conectividad y servicios externos
Cuando una aplicación depende de Internet, DNS, una VPN, una base de datos o un servicio cloud, una incidencia de red puede parecer un fallo de la propia aplicación. Antes de reinstalar software conviene comprobar conectividad, resolución de nombres, latencia y acceso a los servicios de los que depende.
Los problemas de red también pueden ser intermitentes. Paquetes perdidos, WiFi saturado, un switch con errores o una ruta mal configurada pueden provocar fallos difíciles de reproducir si no se recogen métricas y registros durante la incidencia.
Señales de alerta que conviene investigar antes de una caída
Los sistemas suelen avisar mediante cambios de comportamiento. Reinicios inesperados, servicios que tardan cada vez más, errores de escritura, incremento de uso de CPU o memoria, espacio libre que cae rápidamente y eventos repetidos en los registros merecen revisión aunque la actividad todavía continúe.
También importan las señales que aportan los usuarios. Si varias personas describen lentitud a la misma hora o una aplicación falla siempre en el mismo proceso, ese patrón puede señalar un cuello de botella. El historial de soporte es especialmente valioso para detectar recurrencias que un diagnóstico puntual no muestra.
Cómo diagnosticar un fallo de sistema sin empeorar el problema
Delimitar el alcance
Antes de cambiar configuraciones conviene saber a quién afecta el fallo. Hay que comprobar si ocurre en un usuario, un dispositivo, una aplicación, una sede o toda la organización. Delimitar el alcance permite priorizar y evita aplicar cambios generales cuando el problema es local.
También ayuda a revisar la hora de inicio, mensajes de error, servicios relacionados y cambios recientes. Si el incidente aparece solo al acceder a un recurso concreto, el diagnóstico será distinto al de una pérdida general de conectividad.
Conservar evidencias antes de reiniciar
Reiniciar puede restaurar el servicio, pero también hacer desaparecer información útil. Siempre que la situación lo permita, conviene registrar mensajes, eventos, uso de recursos, procesos y estado de las conexiones antes de reiniciar. Esa evidencia ayuda a encontrar la causa si el fallo vuelve a aparecer.
En sistemas críticos hay que equilibrar investigación y continuidad. Si la prioridad es recuperar el servicio, se puede capturar la información esencial, restaurar la operativa y continuar el análisis después con registros, métricas e histórico de cambios.
Restaurar y después investigar
Recuperar la actividad es solo una parte de la resolución. Una vez estabilizado el sistema conviene identificar por qué ocurrió el fallo y qué medida evitará que se repita. Si la causa fue falta de espacio, por ejemplo, liberar almacenamiento resuelve la urgencia, pero será necesario revisar crecimiento, alertas y capacidad.
Cuando intervienen varios proveedores, debe existir una persona o servicio que coordine el diagnóstico. De lo contrario, cada parte puede limitarse a comprobar su componente sin analizar la dependencia entre aplicación, servidor, red y servicios externos.
Prevención: mantenimiento, copias y capacidad de recuperación
Un plan de mantenimiento informático permite revisar actualizaciones, capacidad, estado de los equipos y servidores, registros y tareas preventivas antes de que aparezca una incidencia grave. La frecuencia debe adaptarse a la criticidad del entorno y al ritmo de cambios.
Las copias de seguridad son esenciales, pero deben acompañarse de pruebas de restauración. Saber que una copia existe no garantiza que pueda recuperarse en el tiempo necesario. La empresa debe conocer qué se copia, cuánto se conserva y cuándo se comprobó por última vez el proceso de recuperación.
En algunos entornos, la virtualización facilita la recuperación, el aislamiento y el aprovechamiento de recursos, aunque no sustituye las copias ni elimina la necesidad de mantenimiento. La arquitectura adecuada depende de la carga, la disponibilidad requerida y las aplicaciones que se ejecutan.
Qué aprender de cada incidencia
Después de un fallo relevante conviene documentar causa, impacto, tiempo de recuperación, acciones realizadas y mejoras pendientes. Esa revisión permite priorizar inversiones basadas en problemas reales y no solo en percepciones. Si una parada se debió a capacidad insuficiente, la solución será distinta de la necesaria ante una mala actualización o un corte de red.
La prevención más eficaz combina mantenimiento, monitorización, documentación y recuperación probada. En XTGA trabajamos con empresas para mantener sus sistemas y servidores al día y reducir incidencias. Si los fallos empiezan a repetirse o la infraestructura ha crecido sin una revisión global, analizar el entorno antes de la siguiente caída permite actuar con más margen y menos urgencia.