El mantenimiento de servidores mantiene disponibles, seguros y recuperables los sistemas críticos. No consiste solo en parches: exige monitorizar recursos, comprobar copias, revisar accesos y documentar cada cambio según la criticidad del servicio.
Un servidor de archivos interno no tiene el mismo riesgo que un equipo publicado en Internet o una plataforma de negocio que funciona las 24 horas. Por eso conviene partir de un inventario, asignar responsables y establecer un calendario verificable dentro del servicio de mantenimiento informático.
Qué incluye el mantenimiento de servidores
Monitorización y revisión de alertas
La vigilancia continua debe controlar CPU, memoria, almacenamiento y eventos relevantes. Hay que revisar tendencias para ampliar recursos antes de que el servidor alcance su límite. Una alerta solo es útil si tiene un procedimiento de respuesta asignado.
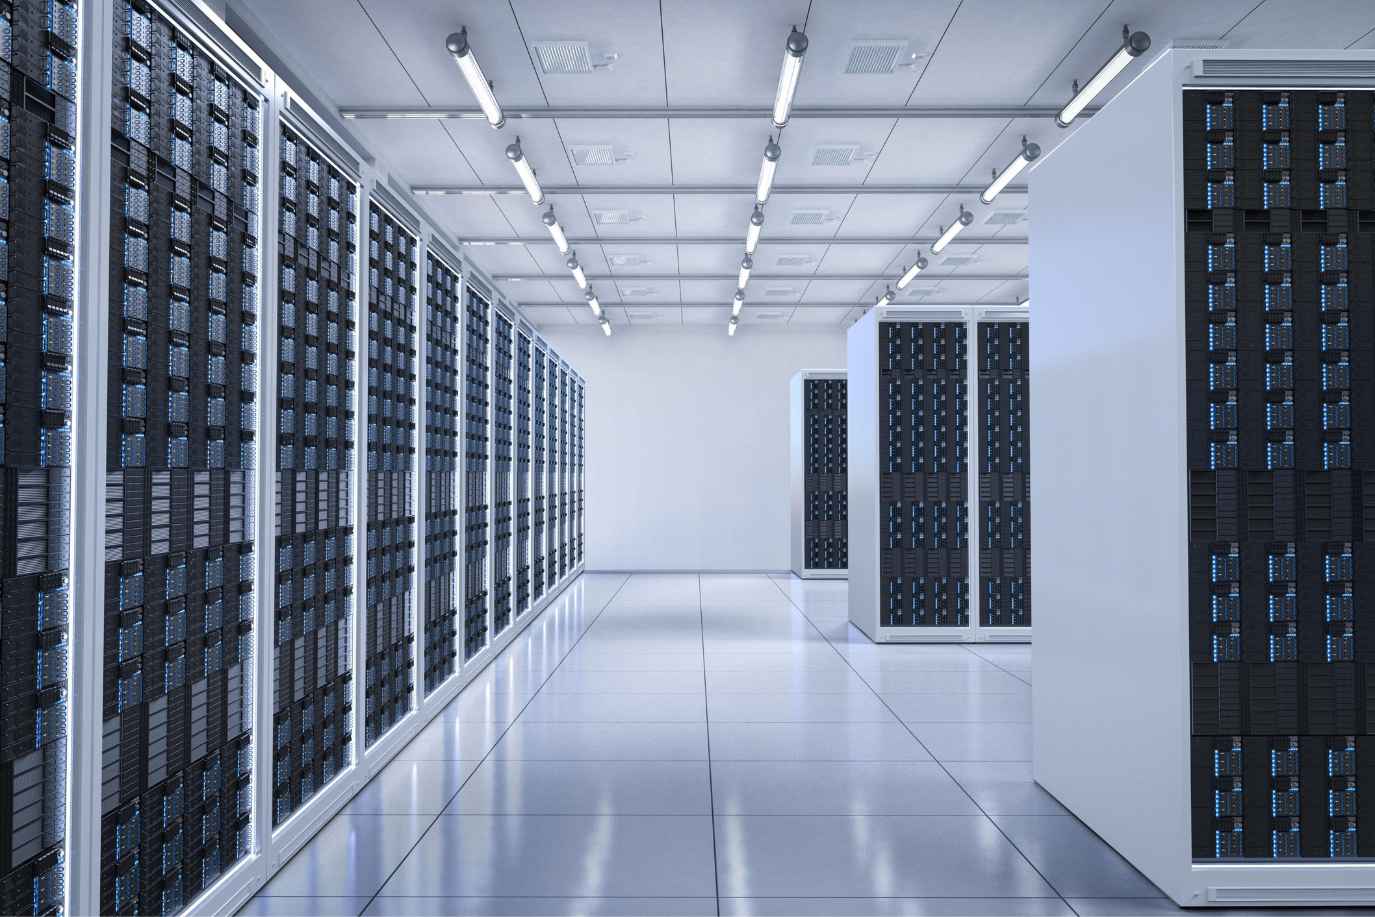
En infraestructuras críticas, esta supervisión se relaciona con la continuidad de un CPD: alimentación, conectividad, climatización y redundancia pueden provocar una caída aunque el sistema operativo funcione correctamente.
Copias de seguridad y restauración
El mantenimiento necesita pruebas periódicas de restauración con tiempos medidos. Comprobar que una tarea aparece como completada no demuestra que la información pueda recuperarse ante un desastre real.
La estrategia cambia según el volumen de datos y el tiempo máximo de pérdida admisible. Una estrategia de seguridad activa y pasiva debe combinar prevención con copias capaces de reconstruir configuraciones, bases de datos y aplicaciones, no solo documentos sueltos.
Parches, firmware y configuración segura
Antes de instalar parches conviene revisar compatibilidades y disponer de un plan de reversión. Las vulnerabilidades críticas requieren valoración inmediata, mientras que otras pueden agruparse en ventanas de mantenimiento planificadas.
La configuración se compara con una referencia aprobada. El hardening del servidor reduce servicios innecesarios, limita puertos y refuerza autenticación y permisos. Sin revisiones, las urgencias y cambios acumulados terminan debilitando esa base.
Usuarios, permisos y registros
Hay que eliminar cuentas obsoletas, revisar privilegios y verificar la autenticación reforzada. Los registros deben conservarse para detectar accesos anómalos y permitir la reconstrucción de posibles incidentes de seguridad.
Cada cuánto realizar las tareas
De forma continua y diaria
A diario se revisan alertas relevantes, fallos de copia y capacidad cercana al límite. La automatización ayuda, pero siempre necesita una persona responsable de interpretar y escalar lo detectado por los sistemas.
Semanal y mensualmente
Mensualmente se revisan parches ordinarios, cuentas, permisos y certificados próximos a caducar. En entornos virtuales, también deben controlarse el hipervisor, los snapshots y la asignación real de recursos físicos.
Trimestral y anualmente
Al menos una vez al año debe realizarse una prueba integral de recuperación y revisar la arquitectura. Cada trimestre es razonable ejecutar restauraciones de muestra, revisar reglas de red y actualizar el inventario técnico.
Cómo organizar un plan útil
El calendario debe indicar tarea, frecuencia, responsable, evidencia y acción ante un fallo. También conviene registrar dependencias de red: comprender los tipos de redes informáticas facilita saber qué equipos, segmentos y comunicaciones sostienen cada servidor.
Un buen mantenimiento se mide por su capacidad para prevenir interrupciones y recuperar el servicio. Cuando las alertas se atienden y los cambios quedan documentados, la infraestructura deja de depender de intervenciones improvisadas.
El plan debe incluir también pruebas posteriores a cada intervención. Después de un parche o cambio de configuración se comprueban servicios, puertos, tareas programadas, copias y registros. Si algo falla, la reversión debe estar preparada y documentada. Aplicar cambios sin validación puede convertir una tarea preventiva en una interrupción.
La frecuencia se revisa cuando cambia la infraestructura. Un nuevo servicio publicado, una migración, más usuarios o un incidente reciente justifican controles adicionales. En cambio, las tareas estables pueden automatizarse siempre que generen alertas fiables y evidencias consultables. Automatizar no significa dejar de supervisar: alguien debe revisar excepciones, fallos silenciosos y tendencias.
También resulta útil clasificar los servidores por criticidad. Los sistemas esenciales necesitan mayor redundancia, ventanas de cambio más controladas y pruebas de recuperación frecuentes. Los menos críticos pueden seguir un calendario más sencillo, pero nunca quedar fuera del inventario. Esta priorización permite dedicar esfuerzo donde una caída tendría mayor impacto sin abandonar el mantenimiento básico del resto.